Claude Opus 5.5 : plus rapide et moins cher, disponible partout le jour même
Anthropic publie Claude Opus 5.5 le 22 septembre : 20 % de moins en tokens, cache à 0,20 $, disponibilité immédiate en API, chez les trois grands clouds et dans Copilot. Faits datés, benchmarks relus, lecture PME.
Dans cet article
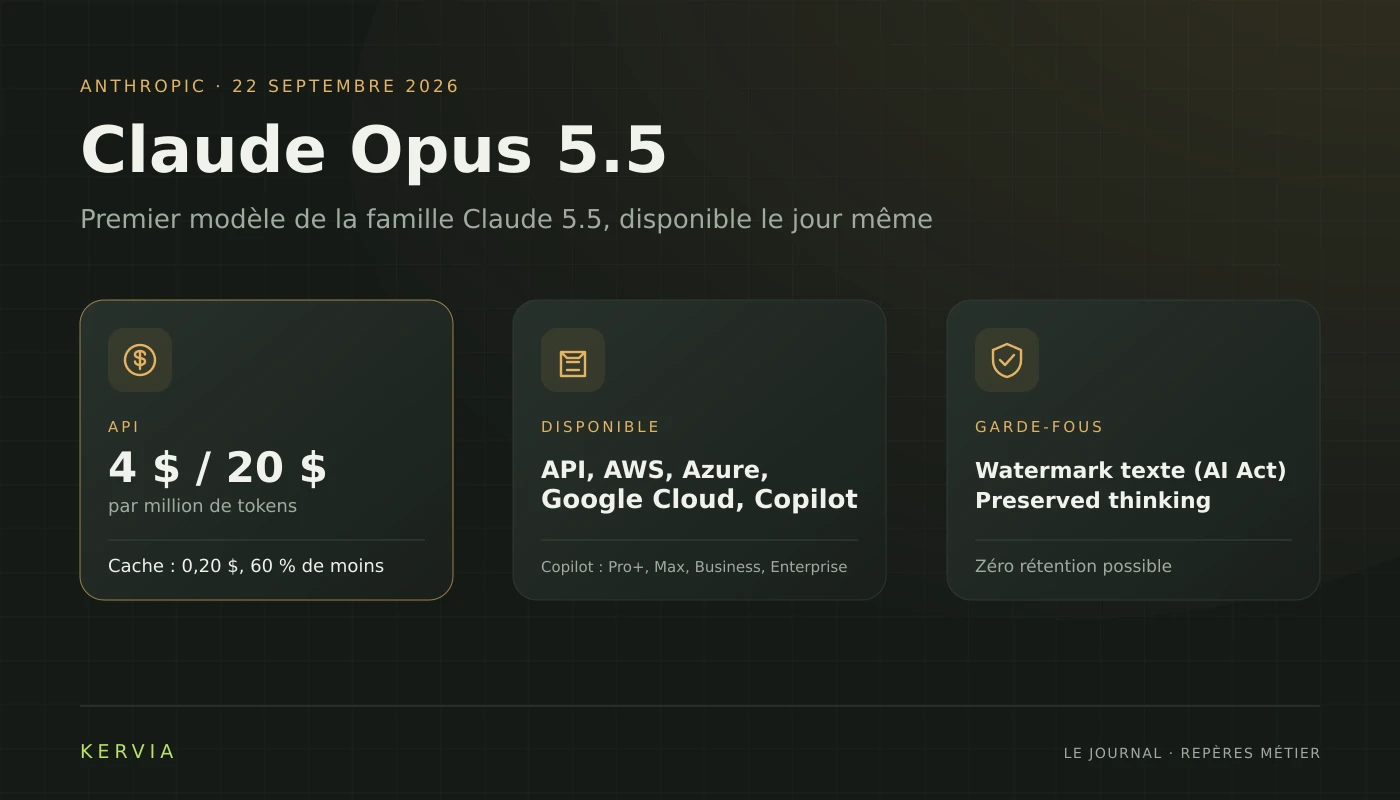
Le 22 septembre 2026, Anthropic a publié Claude Opus 5.5, premier modèle de sa nouvelle famille Claude 5.5. L’éditeur le présente au niveau de Fable 5.1 sur la plupart des travaux, pour un coût d’exécution annoncé en baisse de 40 % par rapport à Opus 5. Le même jour, le modèle est arrivé dans l’API, chez Amazon Web Services, Google Cloud et Microsoft Azure, et dans GitHub Copilot. Pour une PME qui paie ses outils d’IA au token, un flagship qui baisse ses prix est une information qui compte. Voici les faits datés, ce que valent les benchmarks annoncés, et les points à trancher avant d’en faire votre modèle par défaut.
Ce qui est annoncé, et ce qui est disponible
Dans l’annonce du 22 septembre 2026, Anthropic présente Opus 5.5 comme le premier modèle de la famille Claude 5.5, avec les économies d’infrastructure répercutées sur le prix. Claude Sonnet 5.5 et Claude Haiku 5.5 doivent suivre dans les semaines à venir.
Ce que la vérification du 23 septembre permet d’établir :
- le modèle est appelé
claude-opus-5-5dans la documentation de la plateforme : 4 $ par million de tokens en entrée, 20 $ en sortie, 1 million de tokens de contexte, 128 000 en sortie maximale, coupure des connaissances fiable en juin 2026 ; la même page montre que Fable 5.1 reste à 10 $ et 50 $ ; - la disponibilité générale est réelle : API Anthropic, Amazon Web Services, Google Cloud et Microsoft Azure le jour même ;
- GitHub a annoncé le même jour l’arrivée du modèle dans Copilot pour les offres Pro+, Max, Business et Enterprise, avec un déploiement progressif ; si le modèle n’apparaît pas encore dans votre sélecteur, il faut patienter, et les administrateurs Business et Enterprise gardent la main via la politique de modèles ;
- dans l’application Claude, Anthropic augmente les limites d’usage de cinq heures sur les offres Pro, Max, Team et Enterprise, et offre un reset de limite d’utilisation à consommer quand vous le voulez.
Le prix, chiffres en main
Le tarif passe de 5 $ à 4 $ par million de tokens en entrée, et de 25 $ à 20 $ en sortie, soit 20 % de moins qu’Opus 5. Les lectures de cache passent de 0,50 $ à 0,20 $, une baisse de 60 %. La génération est annoncée plus de 30 % plus rapide. Artificial Analysis, mesure indépendante, confirme le 22 septembre la baisse de 20 % et le nouveau tarif de cache.
La baisse la plus intéressante pour un usage agentique n’est pas celle des tokens d’entrée et de sortie : c’est celle du cache. Dans un travail agentique ou de code, la majorité des tokens facturés sont des relectures de contexte déjà envoyé, comme nous l’expliquions pour Fable 5.1 et son cache. Anthropic estime qu’avec ce mélange typique, à réglages par défaut, Opus 5.5 coûte 40 % de moins qu’Opus 5 : un chiffre de l’éditeur, dépendant de votre mélange réel de lectures et d’écritures.
Le même jour, OpenAI a publié GPT-6 Sol et GPT-6 Luna, avec des prix API en baisse de 50 % : 2 $ et 10 $ par million de tokens pour Sol, 0,10 $ et 0,50 $ pour Luna. Au rayon des modèles récents à prix contenu, Grok 4.7 reste à 2 $ et 6 $ depuis le 21 septembre. Opus 5.5 coûte plus cher à l’unité que ces concurrents ; l’argument d’Anthropic n’est pas le prix le plus bas, mais le rapport entre le niveau du modèle et le coût sur les tâches complexes.
Benchmarks : ce que les scores disent, et ce qu’ils ne disent pas
Anthropic publie un tableau comparatif où Opus 5.5 mène sur ses évaluations de code agentique et de travail du savoir : 66,4 % sur Terminal-Bench 4.0, contre 55,8 % pour Fable 5.1, 52,3 % pour Opus 5 et 57,9 % pour GPT-6 Astra ; 54,4 % sur FrontierCode v1.1 ; 1846 sur GDPval-AA v2.1, contre 1735 pour Fable 5.1. Sur AutomationBench, qui mesure des flux de travail métier, Opus 5.5 marque 40,0 % contre 31,4 % pour Fable 5.1 et 26,9 % pour Opus 5, GPT-6 Astra restant devant à 41,4 %.
Trois réserves à garder en tête :
- ce sont des scores publiés par l’éditeur, sur des versions et des niveaux d’effort choisis par lui ; la note du tableau précise que les tâches de cybersécurité et de biologie ont été terminées par des modèles plus anciens quand les garde-fous de production sont intervenus, ce qui dégrade probablement les scores d’Opus 5.5 sur ces axes ;
- la mesure indépendante d’Artificial Analysis place Opus 5.5 en tête de son Intelligence Index, avec 58 au niveau d’effort maximal, le score le plus élevé mesuré par l’organisme à ce jour ;
- Anthropic écrit lui-même que les marges deviennent un guide peu fiable à ce niveau de capacité, et que l’écart réel entre Opus 5.5 et Fable 5.1 est plus étroit que ce que les scores suggèrent. GitHub rapporte de son côté que, dans ses tests internes, Opus 5.5 a résolu des tâches au niveau d’Opus 5 avec nettement moins d’étapes et de tokens.
La décision ne se prend pas sur une ligne de tableau : un essai sur deux ou trois de vos tâches réelles, facturé au prix public, reste le seul juge utile.
Sécurité et données : ce qui change pour un compte existant
Anthropic annonce qu’Opus 5.5 obtient les meilleurs scores à ce jour de son audit comportemental automatisé, qu’il est moins enclin que les modèles récents à prendre des actions difficiles à annuler, et plus résistant à l’injection de prompts qu’Opus 5. Ces affirmations viennent de l’éditeur et de son system card ; des évaluateurs externes, dont METR, ont testé le modèle avant sa sortie. Comme Mythos 5.1 sur les axes biologie et cybersécurité, il est livré avec des garde-fous du niveau de Fable 5.1, et les organisations vérifiées peuvent postuler aux programmes d’accès dédiés.
Trois points concrets se vérifient directement dans la documentation :
- preserved thinking : comme Fable 5.1, Opus 5.5 est concerné pour les comptes API créés à partir du 31 août 2026 ; l’édition du contexte antérieur pour extraire le raisonnement du modèle est bloquée, et une intégration existante doit vérifier sa compatibilité avant de basculer ;
- watermark : les sorties texte sont marquées, une mesure annoncée conforme à l’AI Act ; GitHub précise que dans Copilot, ce marquage ne change ni la qualité ni la lisibilité et n’ajoute ni tokens ni coût ;
- zéro rétention : comme les Opus précédents, le modèle reste disponible avec zéro rétention de données, et le mode de raisonnement ne peut plus être désactivé, ce qui compte pour vos temps de réponse et votre budget.
Pour la règle sur ce que vous collez dans un outil d’IA, notre repère sur les données clients reste le point de départ ; un modèle plus récent ne change pas ce que votre devoir de confidentialité autorise.
La lecture Kervia pour une PME
- Vous payez déjà Opus 5, en API ou dans Copilot : le passage à Opus 5.5 réduit la facture au prix public, surtout si votre usage est agentique et gourmand en cache. C’est le cas d’usage le plus net de l’annonce.
- Vous choisissez un modèle par défaut pour un agent : la documentation Anthropic recommande désormais Opus 5.5 pour la plupart des charges, et réserve Fable 5.1 au raisonnement exigeant et aux tâches longues, quand vos évaluations d’Opus 5.5 à effort élevé restent en dessous. Le choix est plus simple qu’avant.
- Vous comparez le marché : Grok 4.7 à 2 $ et 6 $, GPT-6 Sol à 2 $ et 10 $, Opus 5.5 à 4 $ et 20 $. Le prix à l’unité ne dit rien du nombre de tokens que vos tâches consomment, ni du poids des lectures de cache ; mesurez sur vos propres flux avant de trancher, comme pour tout comparatif d’agents.
Les mots techniques, en clair
- Lecture de cache : quand un agent relit un long contexte déjà envoyé, historique de conversation ou base de code, cette relecture est facturée moins cher qu’un premier envoi. Chez Opus 5.5, elle coûte 0,20 $ par million de tokens, contre 0,50 $ pour Opus 5.
- Preserved thinking : garde-fou contre l’extraction industrielle du raisonnement ; Anthropic empêche les appels API de modifier le contexte antérieur du modèle pour reconstruire sa réflexion.
- Watermark : marquage invisible des sorties texte, annoncé comme conforme à l’AI Act ; il n’ajoute pas de tokens et ne change pas la lisibilité.
- Effort : niveau de raisonnement demandé au modèle, réglable du plus bas au plus élevé ; plus l’effort monte, plus la qualité et le coût augmentent.
Sources : l’annonce Anthropic du 22 septembre 2026, la documentation des modèles, l’entrée Copilot et la mesure d’Artificial Analysis, relues le 23 septembre 2026.
QUESTIONS FRÉQUENTES
Pour aller à l’essentiel.
Claude Opus 5.5 remplace-t-il Fable 5.1 ?
Non, les deux coexistent. La documentation Anthropic recommande Opus 5.5 pour la plupart des charges de travail, et Fable 5.1 pour le raisonnement exigeant et les tâches agentiques longues, quand vos propres évaluations d'Opus 5.5 à effort élevé restent en dessous. Fable 5.1 reste aussi plus cher : 10 $ et 50 $ par million de tokens.
Combien coûte Opus 5.5 dans GitHub Copilot ?
Il est facturé au prix public d'Anthropic, 4 $ et 20 $ par million de tokens, sur les offres Copilot Pro+, Max, Business et Enterprise. Le déploiement est progressif et les administrateurs Business et Enterprise contrôlent l'accès via la politique de modèles.
Le mode de raisonnement peut-il être désactivé ?
Non. Opus 5.5 fonctionne avec un raisonnement adaptatif toujours actif, dont l'effort se règle mais ne se coupe pas. Cela se paie en latence et en tokens, et se vérifie mieux sur vos propres tâches que sur un benchmark.