Grok 4.7 : le nouveau flagship xAI arrive à prix inchangé et dans Copilot
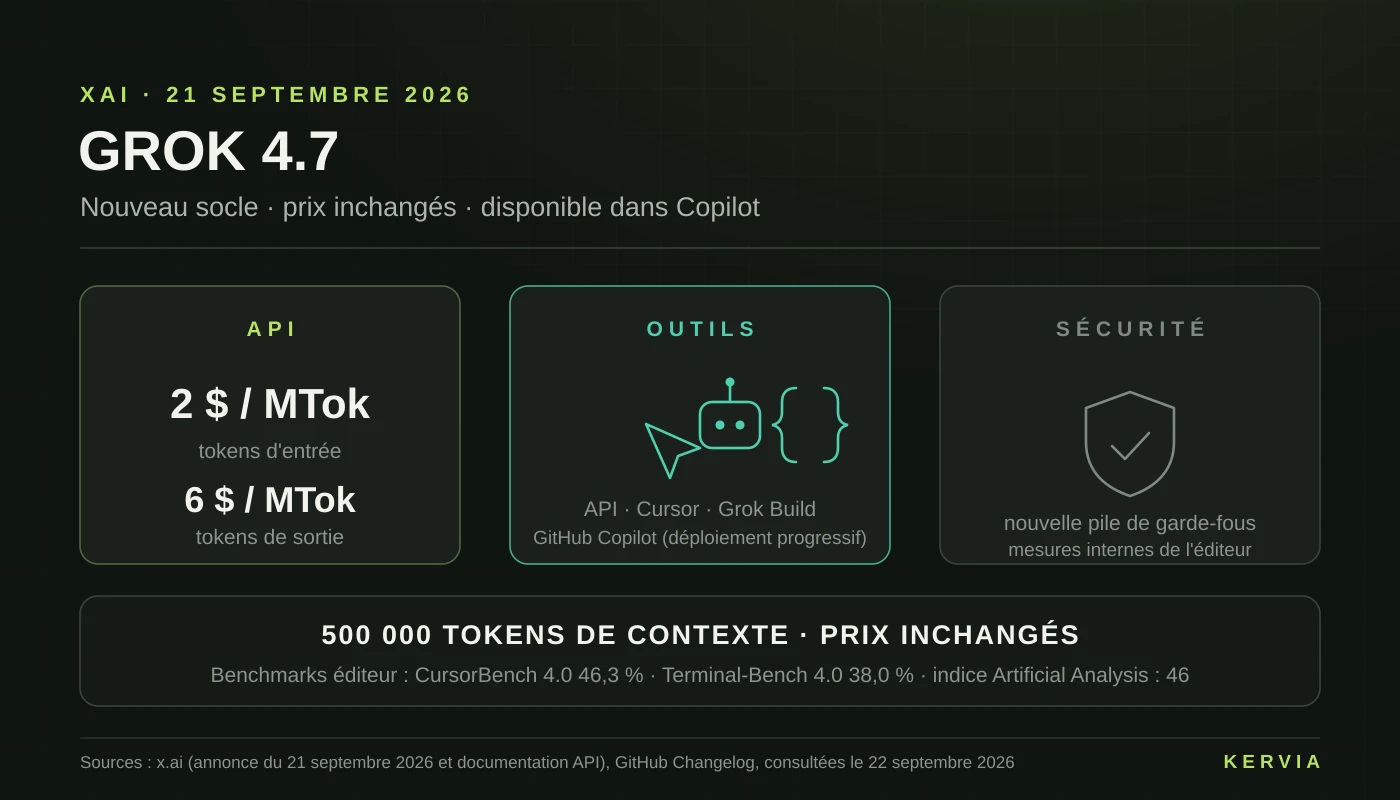
xAI publie Grok 4.7 le 21 septembre : nouveau socle, prix inchangés à 2 $ et 6 $ par million de tokens, 500k de contexte. Faits datés, benchmarks relus, limites et lecture PME.
Dans cet article
- Ce qui est annoncé, et ce qui est disponible
- Ce que les benchmarks annoncés valent
- La facture, au token
- Ce que cela change pour une PME romande
- Les mots techniques, en clair
- Questions fréquentes
- Grok 4.7 remplace-t-il Grok 4.6 ?
- Quel budget prévoir pour un agent de code ?
- Peut-on l’utiliser dans GitHub Copilot ?
- En résumé
Le 21 septembre 2026, xAI, désormais regroupée sous la bannière SpaceXAI, a publié Grok 4.7, son nouveau modèle phare pour le code et le travail du savoir. Il est disponible le jour même dans l’API, dans Cursor et dans Grok Build, et son arrivée dans GitHub Copilot a été annoncée le même jour par GitHub, avec un déploiement progressif. Le prix ne bouge pas par rapport à Grok 4.6 : 2 $ par million de tokens d’entrée, 6 $ par million en sortie. Pour une PME qui paie ses outils d’IA au token, un flagship au prix du modèle de la génération précédente est une information qui compte. Voici les faits datés, ce que valent les benchmarks annoncés, et les points à trancher avant d’en faire le modèle par défaut de vos outils.
Ce qui est annoncé, et ce qui est disponible
Dans l’annonce du 21 septembre 2026, xAI présente Grok 4.7 comme son modèle le plus capable pour le code et le travail du savoir, construit sur une base plus grande que Grok 4.6 et entraîné par un apprentissage par renforcement plus long, orienté vers des tâches qui durent des heures. L’éditeur met en avant une meilleure vérification de son propre travail, une gestion de contexte plus longue et un apprentissage natif du harnais Grok Bot, l’environnement de ses agents persistants.
Ce que la vérification du 22 septembre permet d’établir :
- le modèle est appelé
grok-4.7dans la documentation officielle : 500 000 tokens de contexte, 2 $ par million de tokens d’entrée et 6 $ par million en sortie, effort de raisonnement configurable, coupure des connaissances en mai 2026 ; la page de modèles est datée du 21 septembre ; - cette documentation positionne Grok 4.7 comme modèle généraliste unique : « for everything else, including code, use Grok 4.7 » ;
- l’annonce confirme la disponibilité dans Cursor et Grok Build dès le premier jour, ainsi qu’une variante rapide qui facture le double du prix pour une vitesse de sortie doublée ;
- GitHub a annoncé le modèle pour les offres Copilot Pro, Pro+, Max, Business et Enterprise, sélectionnable dans VS Code, Visual Studio, la CLI, l’agent cloud, l’application, JetBrains, Xcode et Eclipse ; le déploiement est progressif et les administrateurs Business et Enterprise peuvent le désactiver par règle de modèle ;
- l’annonce cite aussi des harnais de code tiers, des routeurs de modèles et des plateformes cloud, sans liste officielle figée au jour de la publication.
Les affirmations de performance et de sécurité viennent de l’éditeur, sauf mesure indépendante citée ci-dessous. C’est le lot de toute annonce de modèle : à lire comme telle.
Ce que les benchmarks annoncés valent
Le tableau publié par xAI compare Grok 4.7 (xhigh) à Grok 4.6 (high), GPT-5.6 Sol (max) et Claude Fable 5.1 (max) :
| Benchmark (domaine) | Grok 4.7 | Grok 4.6 | GPT-5.6 Sol | Fable 5.1 |
|---|---|---|---|---|
| CursorBench 4.0 (code long) | 46,3 % | 40,4 % | 41,7 % | 51,8 % |
| DeepSWE v1.1 (ingénierie, effort haut*) | 71,0 % | 65,2 % | 72,7 % | 70,0 % |
| EEBench (électronique) | 64,0 % | 53,0 % | 39,4 % | 56,4 % |
| AA Briefcase v1.1 (bureau, score) | 1 657 | 1 546 | 1 487 | 1 678 |
| Terminal-Bench 4.0 (terminal) | 38,0 % | 20,3 % | 37,3 % | 57,9 % |
| Harvey Legal Agent (juridique) | 19,6 % | 15,8 % | 2,5 % | 6,7 % |
| HealthBench Professional (clinique) | 56,7 % | 48,5 % | 60,5 % | 62,1 % |
*Indiqué « high effort » par l’éditeur pour DeepSWE.
Trois lectures de ce tableau. D’abord, Grok 4.7 améliore Grok 4.6 sur les sept jeux annoncés, parfois nettement : le travail en terminal passe de 20,3 % à 38,0 %, le juridique de 15,8 % à 19,6 %. Ensuite, il n’est pas premier partout : Fable 5.1 reste devant sur le code long et le score de travail de bureau, GPT-5.6 Sol devant sur l’ingénierie logicielle et le clinique. Enfin, le titre de l’annonce, « twice as fast, at half the price of comparable models », décrit un rapport performance-prix revendiqué, pas une supériorité absolue sur chaque tâche.
Sur GDPval, le travail professionnel multi-heures, le graphique de l’éditeur place Grok 4.7 xhigh (1 695) devant Grok 4.6 high (1 605), derrière Claude Fable 5.1 max (1 735). Les tâches juridiques et de bureau sont précisément celles qui concernent une PME : un modèle qui progresse sur Harvey Legal Agent et AA Briefcase à prix constant change l’équation, même sans être premier de la classe.
Côté indépendant, Artificial Analysis, consulté le 22 septembre, mesure un indice d’intelligence de 46, classé 16e sur 202 modèles, pour un prix identique à celui annoncé. Deux réserves utiles : la vitesse de sortie mesurée, 42 tokens par seconde, est classée lente, et la verbosité est élevée, 240 millions de tokens générés sur l’indice contre une médiane à 94 millions. Un modèle qui écrit long consomme plus d’entrée relue à chaque étape d’un agent : sur des tâches agentiques, la facture réelle suit la verbosité, pas seulement le prix affiché.
Sécurité, l’annonce avance deux mesures internes : 3,3 % de prompts à double usage risqués qui passent sur HackerBench v0.3, le banc de l’éditeur pour les tâches cyber malveillantes, et une première place sur le benchmark de biosécurité de LatchBio à 62,4 %. Les deux jeux appartiennent à l’éditeur ou à ses partenaires, et l’accès aux capacités de red team est réservé à des partenaires invités. À lire comme des engagements de conception, pas comme des garanties mesurées de l’extérieur.
Ce que ces mesures ne disent pas : le niveau réel en français sur vos documents et vos réunions. Aucun jeu public spécifique au français n’est cité dans l’annonce. Pour trancher, testez sur vos propres tâches (lire un benchmark de modèles IA sans se faire avoir).
La facture, au token
Les prix annoncés, inchangés par rapport à Grok 4.6 :
| Usage | Tarif annoncé |
|---|---|
| Tokens d’entrée | 2 $ par million |
| Tokens de sortie | 6 $ par million |
| Variante rapide | double prix, vitesse de sortie doublée |
La remise sur les tokens d’entrée déjà traités (le cache) est mesurée à 75 % par Artificial Analysis, soit environ 0,50 $ par million. Exemple arithmétique, pas un devis : une après-midi de refactoring pilotée par un agent qui consomme 20 millions de tokens d’entrée et 2 millions de sortie revient à environ 52 $ chez xAI (40 $ d’entrée, 12 $ de sortie). Le même volume, aux prix que xAI publie elle-même pour ses concurrents dans son tableau : environ 120 $ avec GPT-5.6 Sol (4 $ et 20 $) et environ 300 $ avec Claude Fable 5.1 (10 $ et 50 $). À performance comparable sur certains jeux, l’écart de prix devient un critère de décision à part entière, pas seulement le score.
Deux garde-fous pour garder la tête froide. La facture réelle d’un agent dépend de la consommation, et la verbosité mesurée de ce modèle pèse justement sur ce poste (combien coûte un agent IA). Et le marché ne s’arrête pas aux modèles fermés : DeepSeek publie des modèles ouverts facturés encore moins cher, avec la possibilité de les héberger vous-même quand la confidentialité l’exige (DeepSeek V4.1-Flash, le cache de Claude Fable 5.1). Les tarifs bougent vite : vérifiez la page de prix officielle avant de chiffrer un projet.
Ce que cela change pour une PME romande
Trois usages rentrent directement dans le cadre : l’assistance au code dans Copilot ou Cursor sans changer d’abonnement, l’analyse de documents longs grâce aux 500 000 tokens de contexte, et les agents multi-heures qui vérifient leur travail, le point fort revendiqué de cette génération. Sur le papier, ce sont aussi les tâches où l’écart de prix avec les concurrents se creuse le plus.
Trois points à trancher avant de se lancer. La consommation réelle : mesurez les tokens consommés par vos tâches sur une semaine représentative, la verbosité mesurée chez ce modèle justifie ce contrôle avant tout choix. Le lieu de traitement : l’API et les outils associés font transiter vos données par l’infrastructure de xAI, appliquez vos règles avant d’envoyer des documents clients (ce qu’une PME peut envoyer à une IA). Le cadre Copilot : le modèle est activé par défaut dans les offres Business et Enterprise sauf règle contraire de l’administrateur, et la facturation suit le prix public du fournisseur en facturation à l’usage ; si vous pilotez le budget Copilot de l’équipe, vérifiez la règle de modèle avant le premier cycle de facturation, pas après la facture.
Si vos outils utilisent déjà Grok 4.6, la transition est sans changement de tarif : mêmes prix, même vitesse de service selon l’éditeur, et la politique d’alias de l’API fait pointer les noms génériques vers la dernière version stable. La question se pose seulement sur les tâches longues, où la 4.7 revendique ses gains les plus nets : là, comparer les deux modèles sur vos propres travaux reste la démarche la plus rentable.
Les mots techniques, en clair
- Flagship : le modèle le plus capable d’un éditeur, celui qui sert de référence pour la génération.
- MTok : million de tokens, l’unité de facturation ; un token vaut environ trois quarts de mot en français.
- Effort de raisonnement (xhigh) : un réglage qui laisse le modèle réfléchir plus longtemps avant de répondre, au prix de tokens supplémentaires.
- Contexte (500k) : la quantité de texte lisible d’un bloc, ici environ 750 pages.
- Benchmark agentique : une évaluation sur des tâches longues avec outils (terminal, bureau, code), pas un simple questionnaire.
- Modèle verbeux : un modèle qui génère beaucoup de tokens pour un même résultat ; la qualité peut monter, la facture aussi.
- Red team : l’usage offensif contrôlé d’un modèle par des spécialistes pour tester ses défenses, ici en accès sur invitation.
Questions fréquentes
Grok 4.7 remplace-t-il Grok 4.6 ?
La documentation xAI présente désormais Grok 4.7 comme le modèle à utiliser pour tout, code compris. La politique d’alias de l’API fait pointer les noms génériques de modèles vers la dernière version stable, et l’annonce précise que la 4.7 est servie au même prix et à la même vitesse que la 4.6. Aucune date de dépréciation de la 4.6 n’était annoncée dans les documents consultés ; les intégrations qui épinglent une version précise restent sur celle-ci.
Quel budget prévoir pour un agent de code ?
À titre d’exemple arithmétique, pas d’un devis : 20 millions de tokens d’entrée et 2 millions de sortie coûtent environ 52 $ aux prix annoncés. Le poste de variation principal, c’est la consommation, pas le prix unitaire : la verbosité du modèle et la longueur des boucles d’agent font plus de différence que 1 $ de plus ou de moins au million.
Peut-on l’utiliser dans GitHub Copilot ?
Oui, sur les offres Pro, Pro+, Max, Business et Enterprise, avec un déploiement progressif annoncé par GitHub le 21 septembre. Le modèle est facturé au prix public du fournisseur dans le cadre de la facturation à l’usage, et un administrateur Business ou Enterprise peut le désactiver par règle de modèle. Pour une équipe, c’est le réglage à cadrer avant le premier cycle de facturation.
En résumé
Ce qui est établi : un nouveau flagship xAI disponible dès le 21 septembre dans l’API, Cursor, Grok Build et en déploiement dans GitHub Copilot, à prix inchangés, avec 500 000 tokens de contexte et une documentation déjà à jour. Ce qui relève de l’éditeur : le détail des scores de benchmarks et les mesures de sécurité, à relativiser avec la mesure indépendante disponible, qui confirme le rapport prix-performance mais pointe la lenteur et la verbosité. Ce qu’il reste à faire : mesurer la consommation réelle de tokens sur vos tâches, cadrer les données envoyées et vérifier la règle Copilot côté administration avant de laisser le modèle devenir le défaut de l’équipe.