GPT-Live-1 : la voix en direct qui délègue le travail à un agent
La voix temps réel d’OpenAI arrive en API : plein duplex, délégation au backend et coût à la seconde. Ce qu’une PME doit vérifier avant de se lancer.
Dans cet article
Le 10 septembre 2026, OpenAI a rendu GPT-Live-1 disponible en général dans son API. La documentation officielle le présente comme son « premier modèle pour des conversations vocales naturelles et expressives, avec gestion fluide des interruptions ». Ce n’est pas un chatbot de plus : c’est la couche voix qui manquait à la gamme d’agents cloud ouverte le même jour en bêta, l’Agents API.
Pour une PME romande, la question concrète est simple : à partir de quand un standard téléphonique, une prise de rendez-vous ou un accompagnement produit peut-il être tenu par une IA qui parle ? Voici ce qui existe désormais, ce que ça coûte et ce qu’il faut vérifier avant d’acheter quoi que ce soit.
Deux parties bien séparées
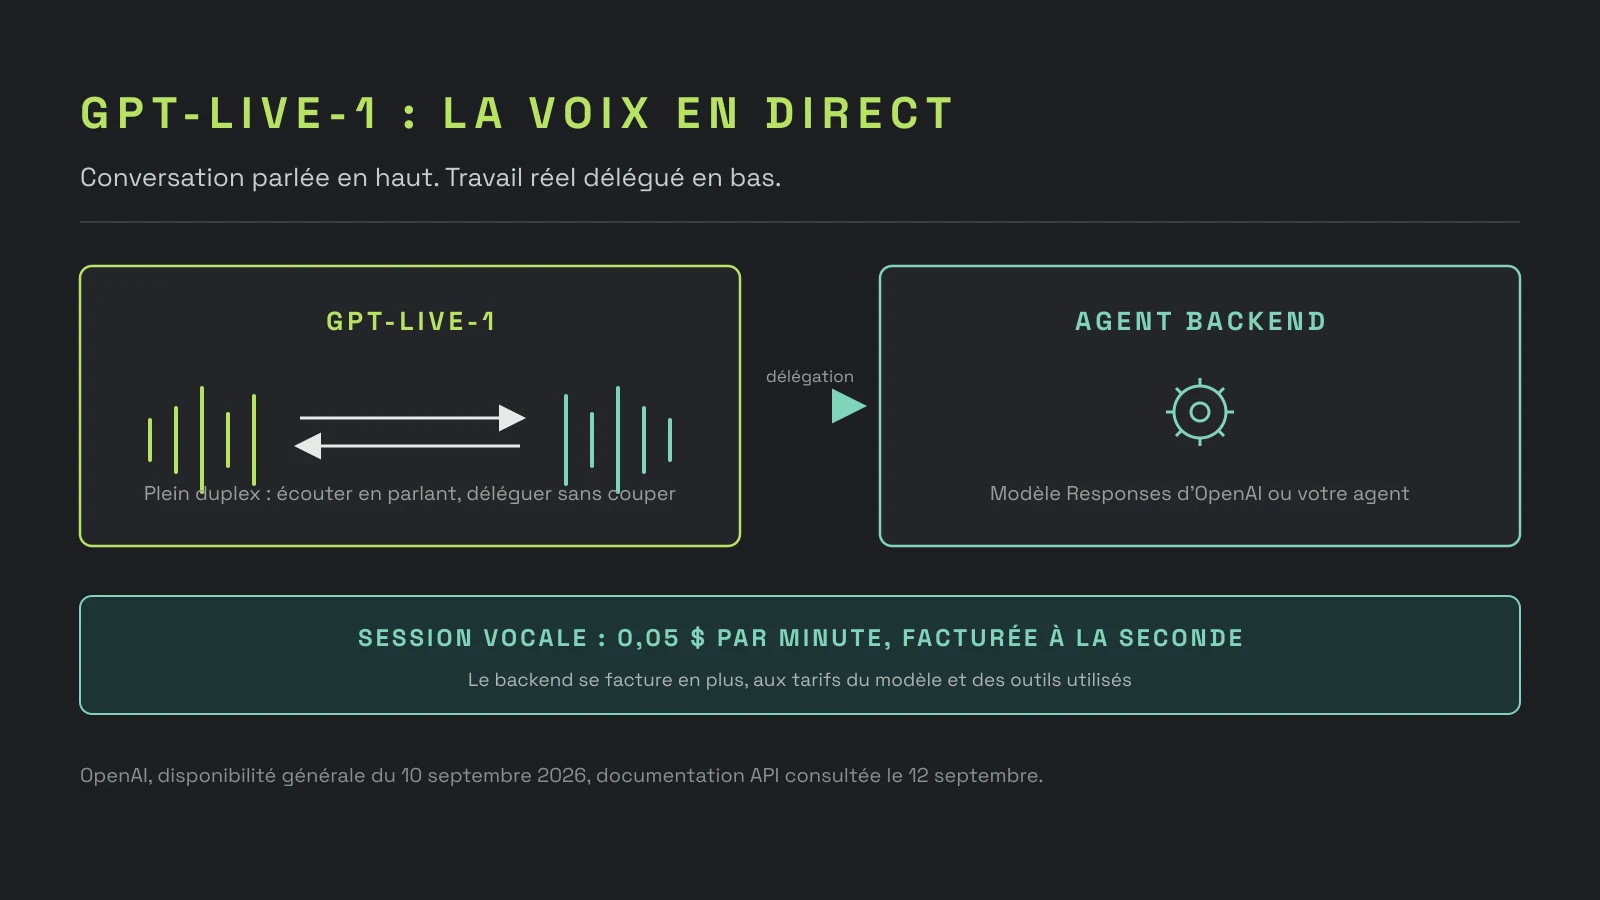
GPT-Live-1 tient la conversation parlée. Il écoute pendant qu’il parle (le « full duplex »), encaisse une interruption, reprend, et sait passer la main. Quand un travail sérieux se profile, il le délègue : la conversation continue pendant que le backend cherche, calcule ou agit.
Le guide officiel donne un exemple parlant : une personne demande où en est une commande, ajoute une précision pendant que le backend vérifie, et entend la réponse quand elle arrive. La parole ne bloque pas le travail, et le travail ne coupe pas la parole.
Deux modes de délégation existent, à choisir à la création de la session :
- Délégation Responses : GPT-Live appelle un modèle Responses d’OpenAI que vous avez configuré. Le plus simple à mettre en route.
- Délégation client : votre application connecte son propre backend, n’importe quel modèle ou service qu’elle fait tourner. Le plus intéressant quand vos règles métier, vos permissions ou vos données ne peuvent pas passer chez l’éditeur.
Le mode est fixé au démarrage de la session ; en changer impose une nouvelle session. Et une précision qui compte pour la conception : interrompre la parole n’annule pas le travail en cours dans le backend.
La facture, en deux lignes
D’après la page du modèle et le changelog du 10 septembre 2026 :
- La session vocale coûte 0,05 $ par minute, facturée à la seconde. La documentation précise que la durée n’est pas arrondie à la minute supérieure : une session de 8 min 40 s coûte environ 0,43 $, pas 0,45 $.
- Le backend se facture en plus, aux tarifs habituels du modèle choisi et des outils utilisés.
Une conversation d’assistance de cinq minutes qui délègue deux recherches web coûte donc la voix (0,25 $) plus le prix des appels backend. Ce découpage a une vertu : il rend un devis vocal lisible. Si un prestataire vous propose un « standard IA », deux chiffres suffisent pour cadrer le coût : minutes parlées et volume de travail délégué.
Autre contrainte à connaître : les limites de débit se mesurent en sessions simultanées. Le palier 1 de l’API ouvre 25 sessions concurrentes, le palier 5 en monte à 500 ; le palier gratuit n’est pas concerné. Pour un standard qui reçoit des appels en parallèle, c’est la donnée de dimensionnement.
Comment ça se branche
Quatre façons de connecter la voix, selon la documentation :
- WebRTC pour une application navigateur : microphone, haut-parleur, canal d’événements.
- WebSockets pour une intégration côté serveur, quand l’audio transite par votre infrastructure.
- Contrôles serveur : une connexion secondaire pour piloter une session existante depuis le backend.
- Téléphonie et SIP pour brancher un vrai numéro de téléphone.
Des intégrations partenaires existent aussi pour LiveKit, Twilio, Telnyx et Daily/Pipecat, ce qui couvre l’essentiel des plateformes téléphonie ou visio qu’une PME utilise déjà.
Un point d’architecture qui devrait rassurer les cas sensibles : la documentation attribue explicitement à votre application les permissions, les confirmations, l’exécution des fonctions privées et l’état durable des tâches. En délégation client, le backend peut rester chez vous.
Ce que ça change pour une PME romande
Les usages crédibles, présentés comme exemples : un standard qui qualifie une demande avant de transférer, une prise de rendez-vous où l’IA vérifie la disponibilité dans l’outil du cabinet pendant que le client parle, un accompagnement produit qui répond en consultant une base de connaissances.
Ce ne sont pas des réglages, ce sont des projets d’agent. La voix n’est que la couche conversationnelle : ce qui fait la valeur, c’est le backend qui vérifie la commande, réserve le créneau ou retrouve la notice. C’est exactement la grille de notre méthode en cinq étapes pour un premier agent utile : une mission bornée, un livrable vérifiable, des chiffres.
Trois points à vérifier avant de se lancer :
- La langue. La documentation ne publie pas de liste de langues prises en charge. Le français fonctionne dans les démonstrations de l’éditeur, mais pour un standard suisse romand, la vérification se fait sur vos propres appels, avec vos accents et votre vocabulaire métier.
- La fraîcheur des connaissances. Le modèle a une date limite de connaissances fixée au 31 juillet 2025. Tout ce qui doit être à jour passe par les outils du backend, pas par le modèle vocal.
- La jeunesse du produit. La disponibilité générale date du 10 septembre. Le jour même, le changelog documentait encore des changements d’interface sur la gamme. Prévoyez que les détails bougent.
Par quoi commencer
Si vous avez un cas vocal en tête, la séquence reste celle d’un agent : un périmètre avec un début et une fin, un backend qui fait le vrai travail, une session de test avec comptage des minutes et des appels backend, puis une décision sur des chiffres. Pour l’infrastructure d’agents elle-même, notre lecture de l’Agents API publiée hier montre où tournent les outils et comment lire un devis.
Les sources de cet article : le guide GPT-Live, la page du modèle GPT-Live-1 et le changelog de l’API OpenAI du 10 septembre 2026, consultées le 12 septembre 2026. Les tarifs cités sont ceux de ces pages à cette date.