DeepSeek V4.1-Flash : un modèle ouvert qui fait baisser la facture IA
DeepSeek V4.1-Flash : poids ouverts sous licence MIT et API d’entrée à 0,15 $ le million de tokens. Lecture PME, sans promesse.
Dans cet article
Le 10 septembre 2026, DeepSeek a rendu public DeepSeek-V4.1-Flash, le plus petit modèle de sa nouvelle famille d’architecture. Deux faits méritent l’attention d’une PME plus que la course aux scores : les poids sont téléchargeables sous licence MIT, et la grille tarifaire de l’API descend sous les 0,20 $ par million de tokens en entrée, hors heures de pointe.
Pour une entreprise qui envisage un agent, la question n’est pas de savoir quel modèle est « le meilleur ». C’est de savoir combien coûte le fait de relire un long contexte des centaines de fois par jour, et quelles libertés la licence laisse. Sur ces deux points, cette sortie change la donne.
Ce qui a été publié, en faits datés
Le changelog officiel du 10 septembre 2026 annonce la sortie. Le modèle est multimodal : il traite nativement du texte et des images, et génère du texte. Il accepte un contexte d’un million de tokens, avec jusqu’à 384 000 tokens en sortie d’après la page de tarifs.
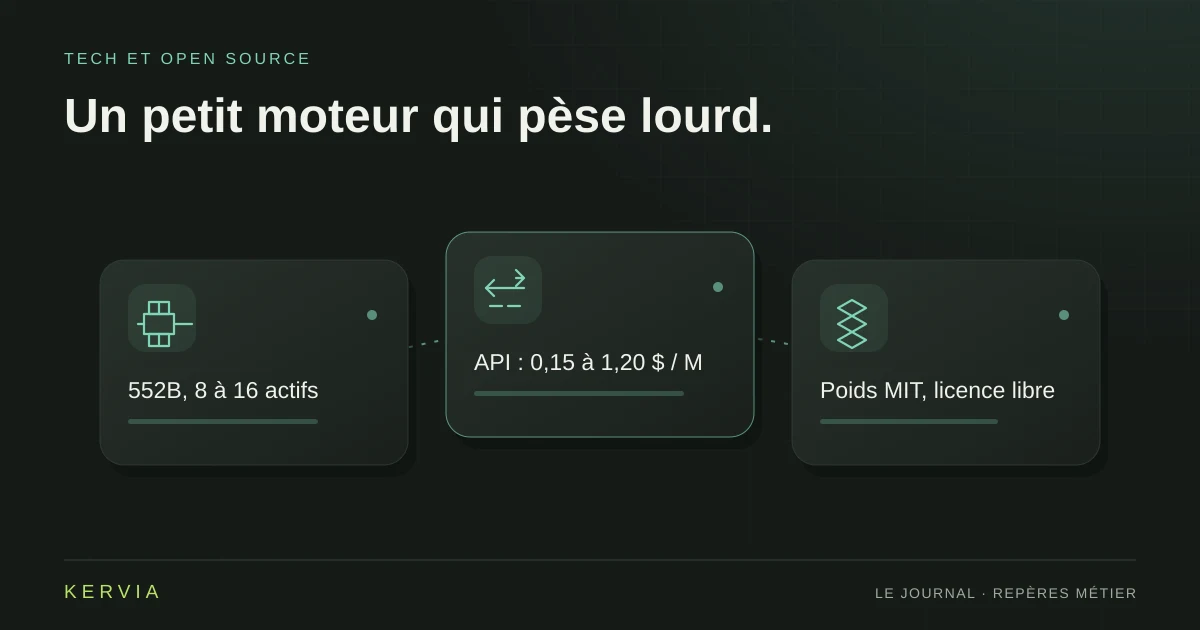
L’architecture, décrite dans l’annonce et la fiche Hugging Face, repose sur un choix assumé : un ensemble de 552 milliards de paramètres, dont 8 milliards seulement sont activés pour traiter l’entrée et 16 milliards pour produire la sortie. La compression du cache interne est l’autre pilier : DeepSeek annonce un besoin divisé par 4 en mémoire rapide et par 8 en stockage par rapport à la génération précédente.
Côté API, le nom du modèle devient deepseek-flash. Les anciens noms deepseek-v4-flash et deepseek-v4-flash-vision-exp restent acceptés mais pointent vers ce nouveau modèle. Le grand frère V4-Pro, que l’annonce voulait remplacer dès le 14 septembre, reste finalement disponible : DeepSeek indique dans le changelog qu’il continue le service après cette date, facturation inchangée, « en réponse à la demande des utilisateurs ».
Les mots techniques, en clair
- Token : l’unité de texte que le modèle lit et écrit, environ trois quarts de mot.
- MoE (mixture of experts) : le modèle contient beaucoup de paramètres mais n’en active qu’une petite partie à chaque étape, ce qui réduit le coût de chaque requête.
- Cache (cache hit) : quand une partie du contexte a déjà été traitée, l’API la relit depuis une mémoire préparée. C’est nettement moins cher, et c’est le cas typique d’un agent qui repart de la même conversation.
- Hors pointe (off-peak) : les heures creuses du fournisseur. Chez DeepSeek, les créneaux de pointe sont 01h00-04h00 et 06h00-10h00 UTC, soit en heure suisse d’été 03h00-06h00 et 08h00-12h00. Le reste du temps, les prix sont moitié moins chers.
La grille des prix, et ce qu’elle change
D’après la page de tarifs du 13 septembre, le modèle deepseek-flash se facture par million de tokens :
| Poste | Hors pointe | Pointe |
|---|---|---|
| Entrée, contexte déjà en cache | 0,003 $ | 0,006 $ |
| Entrée, contexte neuf | 0,15 $ | 0,30 $ |
| Sortie | 0,60 $ | 1,20 $ |
Le détail qui compte pour un agent n’est pas la ligne « contexte neuf » : c’est la ligne du cache. Un assistant qui suit un dossier de 200 pages relit ce dossier à chaque échange. Si ces relectures passent par le cache, le coût d’entrée tombe à 0,003 $ par million de tokens, cinquante fois moins que le prix d’entrée standard hors pointe. C’est exactement le poste que notre article sur le coût d’un agent IA identifiait comme le plus difficile à estimer.
Comparé au grand modèle de la même maison, au même moment et sur la même grille : l’entrée hors pointe de V4.1-Flash coûte environ 4,4 fois moins cher que V4-Pro, et la sortie environ 3,3 fois moins. Ces rapports se calculent sur la page de tarifs citée plus haut ; ils n’engagent que la grille de prix, pas la qualité.
Poids ouverts MIT : la liberté maximale, à la bonne échelle
La licence MIT est la plus permissive des licences ouvertes courantes : usage commercial, modification, redistribution, sans les conditions spécifiques qu’imposent certaines licences communautaires. C’est le point que détaille notre article sur les modèles open weights pour PME : une licence large ne règle pas la question de l’exploitation.
Car les poids, dans leur format de publication FP8, pèsent plus de 500 Go répartis en 48 fichiers. Les faire tourner correctement demande un parc de GPU, du stockage rapide et une exploitation sérieuse. Ce n’est pas un projet de PME, c’est celui d’un hébergeur. Pour une entreprise, les chemins réalistes restent l’API officielle, un hébergeur qui montera le modèle, ou un outil intégré qui le proposera. Les limites de l’auto-hébergement sont détaillées dans notre article self-host un LLM : la licence ouvre la porte, la matière première la referme.
Ce que l’éditeur annonce, et ce qui reste à mesurer
Le changelog publie des scores élevés sur des tests d’agentique et de raisonnement, dont un 90,9 sur GPQA Diamond et un 90,6 sur Terminal-Bench 2.1. Ce sont des résultats communiqués par DeepSeek elle-même, obtenus avec sa propre configuration de test. Ils disent que le modèle existe et vise haut ; ils ne disent pas comment il se comporte sur vos documents, vos outils et votre français. Aucun classement indépendant ne valide ces chiffres au moment de la rédaction.
Le modèle propose aussi un réglage d’« effort de raisonnement » de 1 à 100, qui arbitre entre coût et précision. C’est un levier utile, à condition de le tester : un effort élevé coûte plus cher et répond plus lentement.
La méthode qui reste valable : prendre une tâche réelle et bornée, faire tourner le modèle et votre solution actuelle sur les mêmes données, comparer qualité et facture, décider sur des mesures. Un score d’annonce n’est pas un résultat mesuré chez vous.
Où passent vos données
L’API officielle est opérée par DeepSeek, entreprise établie en Chine. Chaque requête transmet donc vos contenus hors de Suisse et de l’Union européenne. Cela ne rend pas le service illégal : cela veut dire que le traitement de données personnelles doit être examiné avant, information des personnes incluses, comme pour tout fournisseur hors UE. Notre article sur ce qu’on peut envoyer à une IA propose une grille de décision simple.
Détail pratique : l’API propose aussi un point d’entrée au format Anthropic, ce qui simplifie le branchement d’outils conçus pour ce format. La compatibilité d’interface ne change rien au flux des données : les tokens partent chez le même opérateur.
Pour des contenus sensibles, la licence MIT garde une vertu : si un hébergeur de confiance ou une solution interne devient un jour capable de faire tourner ce modèle, rien dans le contrat ne l’interdit.
Une façon raisonnable d’essayer
Si vos agents coûtent cher en contexte relu, le test vaut une heure : prendre un flux réel, mesurer le volume de tokens d’entrée et de sortie, le refaire sur deepseek-flash avec les tarifs hors pointe et de pointe, comparer la facture et la qualité à votre solution actuelle. Si le gain n’est pas net, rien n’est perdu. S’il l’est, vous saurez précisément pourquoi, et vous pourrez en parler chiffres en main.
Cet article décrit une offre au 13 septembre 2026, sur la base des sources officielles citées. Les prix et les disponibilités évoluent vite : revérifiez la page de tarifs avant toute décision.
Sources
- Annonce DeepSeek-V4.1-Flash, api-docs.deepseek.com, 10 septembre 2026.
- Changelog de l’API DeepSeek, entrée du 10 septembre 2026.
- Modèles et tarifs de l’API DeepSeek, consulté le 13 septembre 2026.
- Fiche du modèle et poids sur Hugging Face, licence MIT, 10 septembre 2026.